CI13XX离在线大模型对话SDK_V3.0.19开发流程
1. 概述
离在线大模型对话SDK(CI13XX_SDK_LLM_AIoT_V3.0.19) 相对于算法SDK新增功能有:录音音频数据上传(压缩/非压缩)、SPEEX、OPUS和G722编解码、播放网络音频数据(MP3/PCM/G722)、本地NN VAD端点检测;
名词解释
- SPEEX —— Speex是一种采用 CELP 算法,针对人类语音频率范围(300-3400Hz)进行高度优化,在低码率下能保持清晰语音可懂度的音频编解码器。
- OPUS —— Opus是一个有损声音编码的格式,以语音编码为导向的SILK和低延迟的CELT。在几乎所有比特率下,其音质都显著优于同期的其他编解码器(如 MP3、AAC、Speex、G722 等)。尤其是在中低码率下,优势非常明显。
- G722 —— G722是最早被广泛采用的宽带语音编码器之一,技术成熟稳定。虽然带宽较宽,但其核心技术(SB-ADPCM)仍然是为语音优化的,不适合压缩音乐。
- VAD —— VAD(语音活性检测)是一项用于语音处理的技术,目的是检测语音信号是否存在。V3.0.19 起对外 VAD 由 TVAD(对外称 NN VAD)承载。
- BNPU —— 启英泰伦自研神经网络处理器,V3.0.19 中算法运行于 BNPU 核,与 MCU 核构成双核架构。
2. 算法功能使用说明
2.1 算法使能开关定义在 CI13XX_SDK_LLM_AIOT_Vx.x.x\system\user_alg_config.mk 文件中,通过修改对应的 USE_xxx 变量(置 1 开启、置 0 关闭)选择使用的算法功能;各工程 project_file\makefile 会读取该公共配置并自动定义、使能对应宏,用户不需要再去重复定义相关宏参数。例如:应用中如果需要用到自学习+回声消除+NN 降噪,将 USE_ASR、USE_CWSL、USE_AEC、USE_NN_DENOISE 置 1 即可:
USE_ASR           := 1
USE_CWSL          := 1
USE_AEC           := 1
USE_NN_DENOISE    := 1
USE_NN_VAD        := 1
3.2 各算法使能开关和算法功能对应关系表如下:
| 开关 | 算法功能说明 |
|---|---|
USE_ASR |
开启 ASR 识别 |
USE_ANY_MIC |
开启任意 MIC 识别(双麦) |
USE_AEC |
开启回声消除 |
USE_CWSL |
开启自学习 |
USE_NN_DENOISE |
开启 NN 深度降噪 |
USE_NN_VAD |
开启 TVAD(对外 NN VAD) |
USE_GCC_DOA |
开启 GCC 声源定位 |
USE_NN_DOA |
开启 NN 声源定位(暂不支持) |
USE_IIS_RECORD |
开启 IIS 采音 |
USE_REF_IN_FROM_INNER_CODEC |
双麦算法时使用模拟右麦作参考信号(V3.0.19 新增;置 1 后 makefile 向两个核传递 -DREF_IN_FROM_INNER_CODEC=1,需同步使能 AUDIO_IN_FROM_DMIC) |
V3.0.19 起移除的开关
USE_DEREVERB(去混响)与 USE_TRA_DENOISE(传统降噪)在 V3.0.19 的 user_alg_config.mk 中已**不再提供**,两者默认关闭(system/sdk_default_config.h 中默认值为 0),官方暂不支持开启。
注意
- V3.0.19 起 BNPU 核工程位于
components/bnpu_core_alg_pro,且支持**自动联动构建**:MCU 核工程 makefile 会比对user_alg_config.mk与 BNPU 工程宏快照components/bnpu_core_alg_pro/project_file/config.a(比对工具utils/parse_user_alg_config_mk.lua),宏不一致或 BNPU 库缺失/陈旧时自动重建 BNPU 核工程,无需再手动先编 BNPU 工程; user_alg_config.mk中的*_USE_BNPU_SRAM_SIZE内存表用于 BNPU 端内存分配,一般无需修改(V3.0.19 已随算法更新调整:AEC 30K、NN 降噪 47K、GCC DOA 23K)。
4. 模型ID定义:
开启算法功能需使用不同的前端算法模型,各个算法模型对应ID如下表:
| 模型ID | 模型类型 | V3.0.19 随包模型 |
|---|---|---|
| 60003 | NN深度降噪模型 | [60003]ANS1-061.bin |
说明
- V3.0.19 默认 ASR 模型升级为 PRO5 V02142(语言模型
lm_chinese_CI1306_V02142.dat、声学模型G3-FS-CH-S-V02142.fefixbin458);NN 降噪模型替换为 ANS1-061; - V3.0.19 起 DOA 模型(原 60004
nn_dual_mic_doa_v0003.bin)不再随包提供:三个模板工程的firmware/dnn已删除该模型,NN DOA 暂不支持,双麦声源定位请使用 GCC DOA(USE_GCC_DOA,无需算法模型); external\model目录在 V3.0.19 中精简为仅保留 NN 降噪模型(external\model\nn_denoise\[60003]ANS1-061.bin)。
5. SDK开发包下载:
5.1 注册并登录AI开发平台:https://aiplatform.chipintelli.com
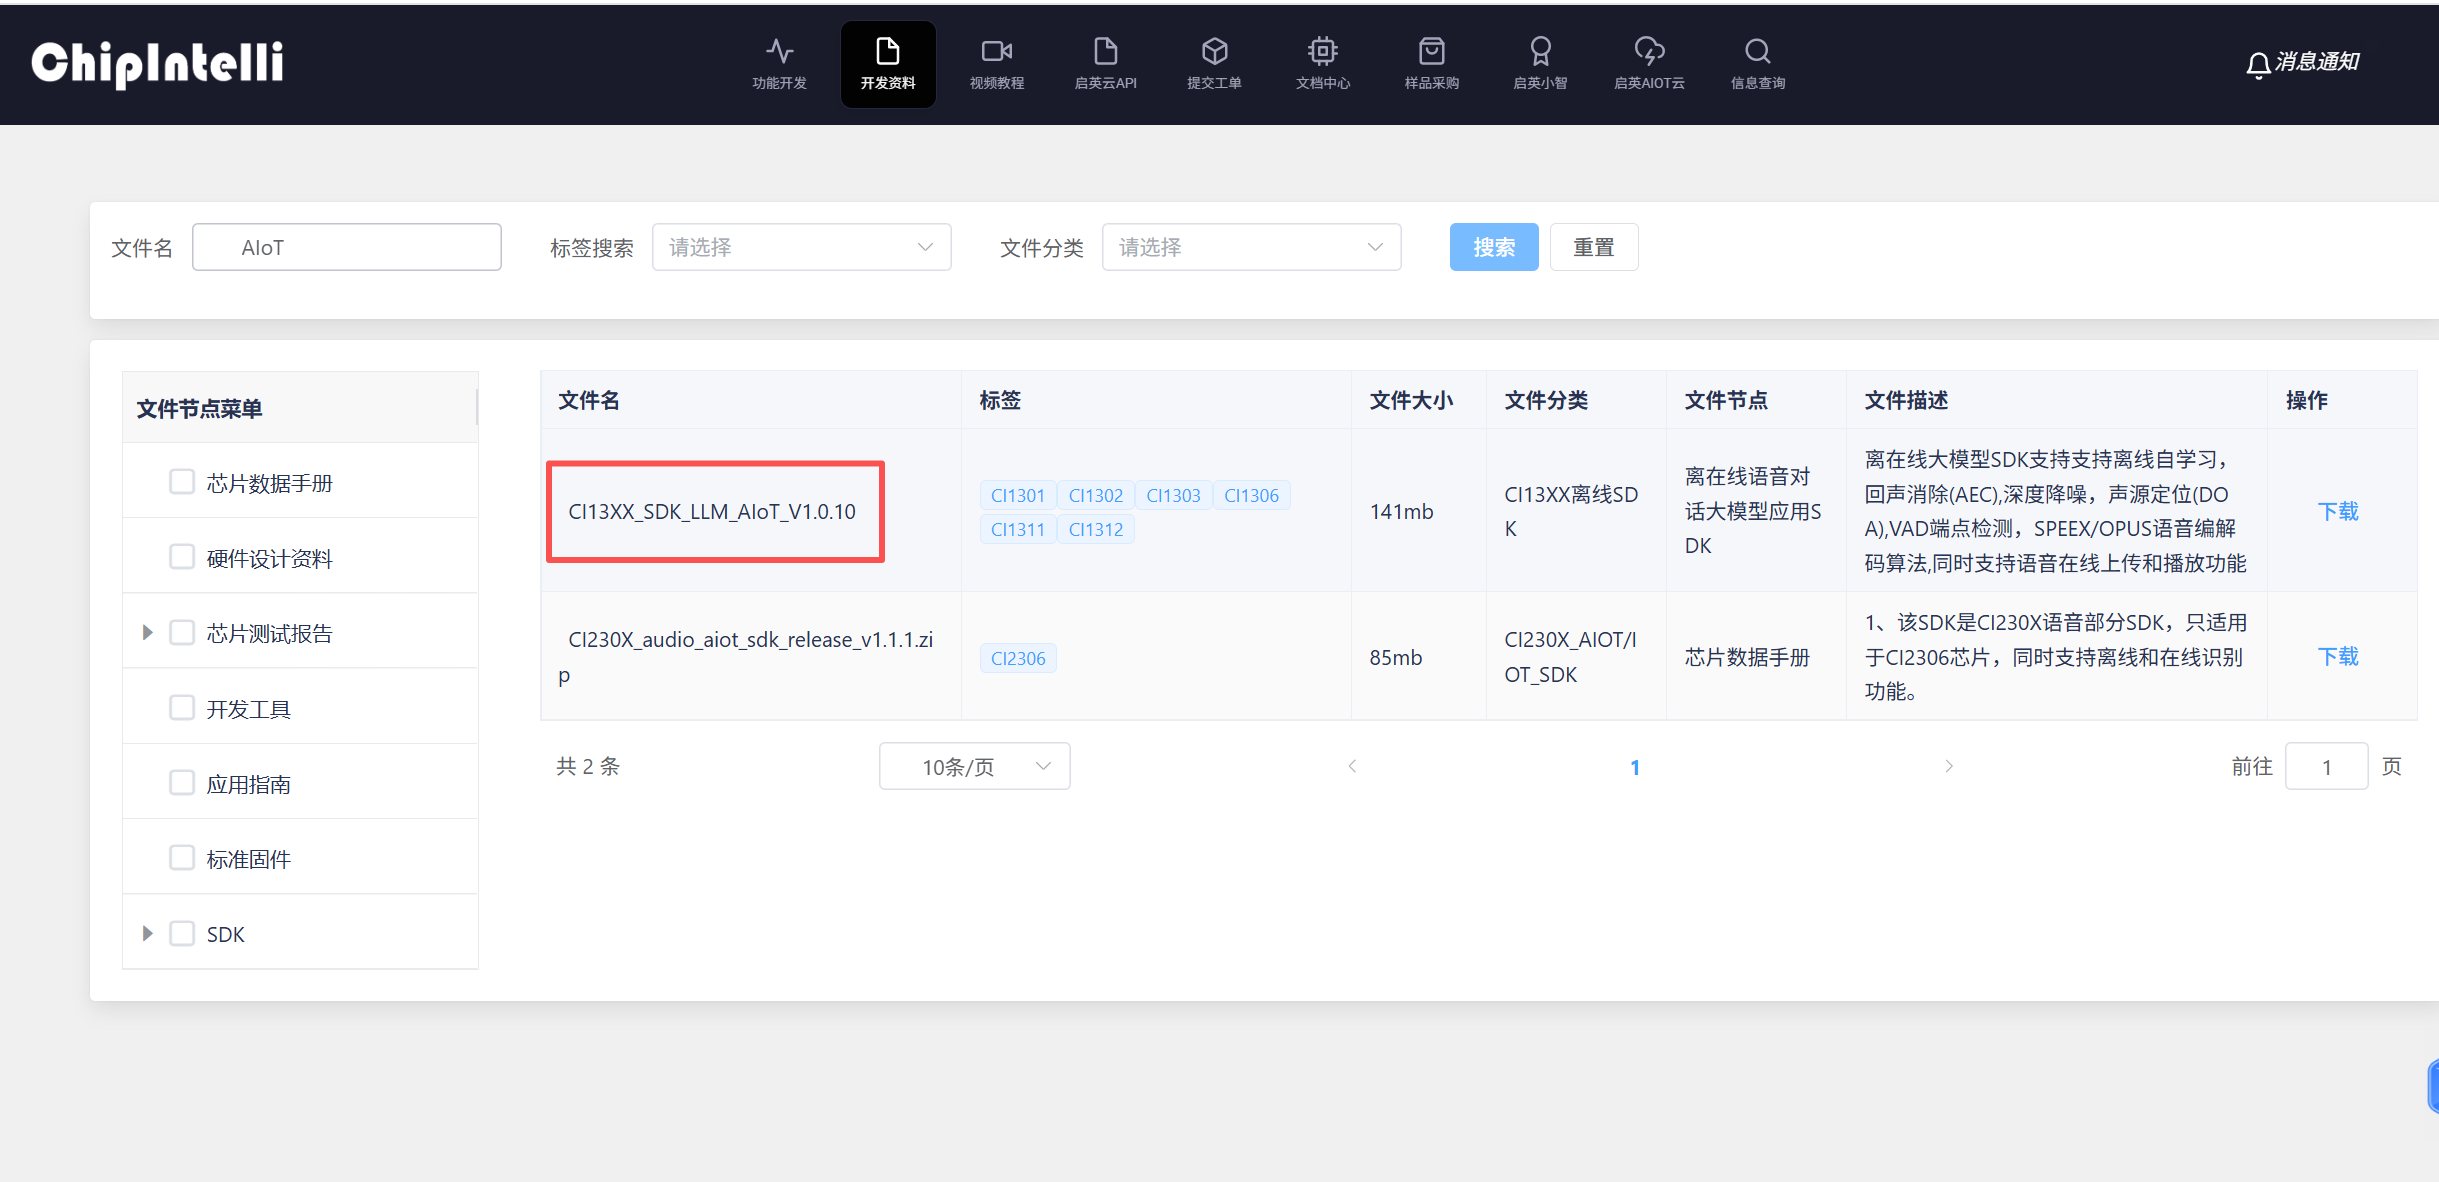
5.2 获取离在线大模型SDK CI13XX_SDK_LLM_AIOT_VXX的软件开发包:https://aiplatform.chipintelli.com/attachment, (若有新版本,请使用最新版本的SDK),如下图:
6. WiFi/4G芯片和启英语音芯片对接离在线方案:
6.1 上传和播放音频参数+交互协议+指令说明: 请采参考离在线大模型对话SDK对接协议说明文档☞启英泰伦离在线大模型对话SDK对接参数及协议说明
6.2 方案对接说明: 离在线大模型对话SDK前端方案说明文档☞启英泰伦离在线大模型对话对接方案说明